GPU SM 구조 완벽 이해하기: 작은 공장이 모여 거대한 AI를 움직인다
AI 모델을 학습하거나 3D 그래픽을 처리할 때 GPU는 엄청난 연산 성능을 발휘합니다.
그런데 GPU 내부를 들여다보면 수백 개의 작은 공장이 있다는 사실, 알고 계셨나요?
이 공장이 바로 **SM(Streaming Multiprocessor)**입니다.
SM은 단순히 숫자를 더하고 곱하는 연산기가 아니라, 수천 명의 인턴 연구원이 동시에 일하는 첨단 연구소와 같습니다.
오늘은 이 SM 내부를 비유를 통해 쉽고 재미있게 설명해 드리겠습니다.
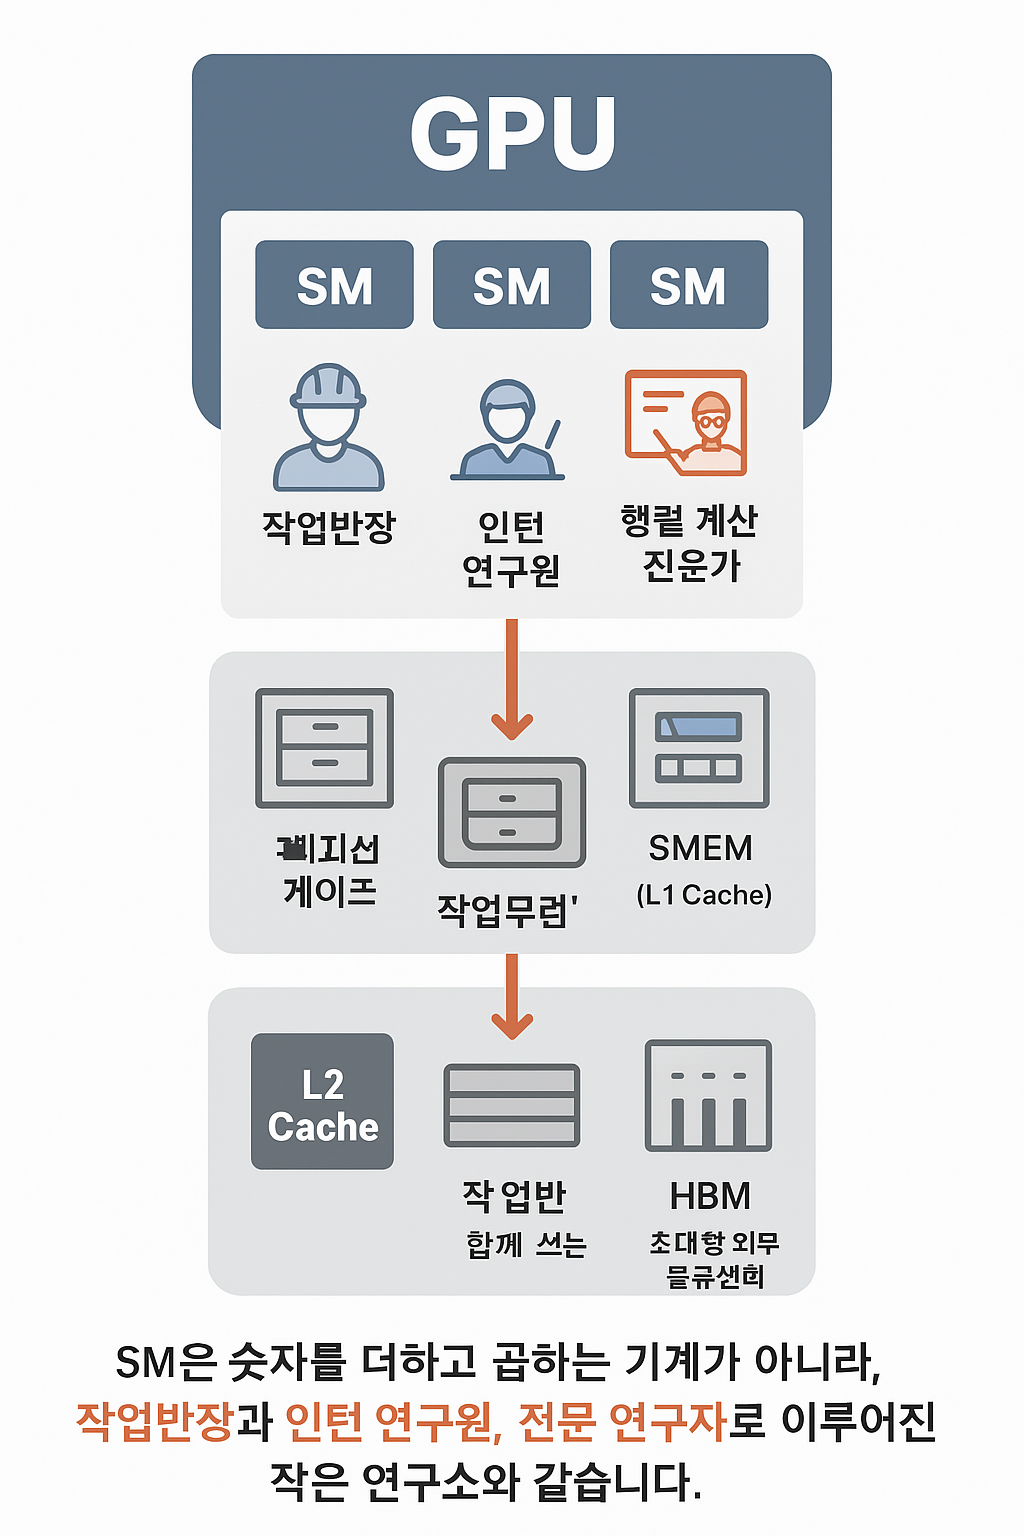
1. Warp Scheduler ― 작업 분배 매니저
공장에 일이 들어오면 제일 먼저 움직이는 관리자가 있습니다.
바로 Warp Scheduler입니다.
- 워프(Warp): 32개의 스레드로 구성된 작업 단위
- Warp Scheduler 역할
- 수천 개의 작업을 워프 단위로 묶어 효율적으로 분배
- 어떤 워프는 벡터 연산, 다른 워프는 행렬 곱셈 등으로 지시
- 최대 64개의 워프를 동시에 관리해 공장은 늘 바쁘게 돌아갑니다.
비유
Warp Scheduler = “작업반장 겸 스케줄러”
2. CUDA Core ― 다재다능한 일꾼
스케줄러가 내린 지시를 받아 가장 많이 움직이는 일꾼이 있습니다.
그게 바로 CUDA Core입니다.
- 주요 역할
- 벡터 연산, 행렬 연산 등 SIMD/SIMT 기반 계산 수행
- 조건문이 있는 복잡한 코드 처리 가능
- 단, 같은 워프 내에서 **서로 다른 분기(branch)**로 가면 속도가 떨어짐
비유
CUDA Core = “다재다능한 인턴 연구원”
3. Tensor Core ― AI 연산 특화 전문가
AI와 머신러닝의 핵심은 거대한 행렬 곱셈입니다.
이를 위해 등장한 GPU 속 “전문가”가 바로 Tensor Core입니다.
- 특징
- 행렬 곱셈에 최적화
- FP16, FP8, INT8 등 낮은 정밀도 연산에서 초고속 성능 발휘
- CUDA Core보다 수십 배 높은 연산 성능(FLOPs) 보유
비유
Tensor Core = “AI 연산 특화 전문가”
4. 레지스터 파일 ― 개인 서랍장
연구원이 일을 하려면 자료가 필요합니다.
각 CUDA Core와 Tensor Core는 자신만의 작은 서랍장을 갖고 있는데, 이를 레지스터 파일이라고 합니다.
- 연산에 필요한 데이터를 가장 빠르게 꺼내 쓸 수 있는 공간
- 단, 용량이 작아 오래 보관하기는 어려움
비유
레지스터 = “각 연구원의 개인 서랍”
5. SMEM(L1 Cache) ― 팀 공유 창고
SM 내부에는 팀원들이 함께 쓰는 작은 창고도 있습니다.
이게 바로 **SMEM(Shared Memory, L1 Cache)**입니다.
- 여러 CUDA Core가 동시에 데이터 접근 가능
- 워프 단위 협업에 최적화
- 다만 용량이 작아 자주 비워줘야 함
비유
SMEM = “작업반이 함께 쓰는 공유 창고”
6. L2 Cache & HBM ― 외부 물류창고
SM 내부의 작은 창고만으로는 대규모 연구를 감당하기 어렵습니다.
그래서 GPU는 더 큰 중앙 창고와 외부 물류센터와 연결되어 있습니다.
- L2 Cache → 공장 전체가 공유하는 중앙 창고
- HBM(High Bandwidth Memory) → GPU 외부의 초고속 대형 물류센터
- 데이터 이동 경로:
레지스터 → SMEM → L2 Cache → HBM - 거리가 멀수록 속도가 느려지므로, 데이터를 가까이 두는 최적화가 중요
비유
HBM = “초대형 외부 물류센터”
7. GPU 내부의 유기적 흐름
GPU의 SM은 단순한 부품의 집합이 아니라 유기적으로 협업하는 연구소입니다.
작업 하나가 처리되는 과정을 보면 더 잘 이해할 수 있습니다.
작업 처리 순서
- 작업 요청 → 행렬 곱셈, 벡터 연산 등 다양한 연산이 들어옴
- Warp Scheduler가 워프 단위로 작업을 분배
- CUDA Core는 일반 연산, Tensor Core는 대규모 행렬 곱셈 수행
- 필요한 데이터는 레지스터 → SMEM → L2 → HBM 순서로 가져옴
- 결과를 다시 레지스터/SMEM에 저장 후 상위 메모리로 전달
이 과정을 수백 개의 SM이 동시에 수행하기 때문에,
GPU는 **테라플롭스(TFLOPs)**에서 **페타플롭스(PFLOPs)**까지 엄청난 연산을 처리할 수 있습니다.
8. 비유로 보는 SM 구조
| Warp Scheduler | 작업 분배 및 관리 | 작업반장 |
| CUDA Core | 범용 연산 처리 | 다재다능한 인턴 연구원 |
| Tensor Core | AI·행렬 연산 전문가 | 특화된 연구 전문가 |
| 레지스터 | 빠른 데이터 접근 | 개인 서랍 |
| SMEM(L1 Cache) | 팀 단위 공유 메모리 | 작은 작업반 공유 창고 |
| L2 Cache | 공장 전체 중앙 창고 | 사내 메인 창고 |
| HBM | 외부 고속 메모리 | 대형 외부 물류센터 |
결론
SM은 단순한 연산기가 아니라 잘 조직된 작은 연구소입니다.
수백 개의 SM이 협력해 AI 모델 학습, 과학 시뮬레이션, 그래픽 렌더링 등
현대 컴퓨팅의 핵심을 움직이고 있습니다.
앞으로 GPU 성능을 제대로 이해하고 활용하려면,
SM 내부의 작업 흐름과 데이터 이동 구조를 아는 것이 필수입니다.